Una API puede devolver un 404 correcto y aun así seguir siendo incómoda de integrar.
Ese problema aparece cuando el backend trata el error como texto libre y espera que el frontend "entienda" qué pasó leyendo mensajes pensados más para debugging que para lógica de producto. Mientras el proyecto es chico, eso suele pasar desapercibido. Cuando empiezan a aparecer formularios reales, validaciones específicas y feedback distinto según el caso, deja de ser tolerable bastante rápido.
Eso lo terminé resolviendo en dos APIs distintas:
proyecto-atlas-api, en ASP.NET Coremodo-playa-api, en NestJS
Los dos proyectos necesitaban lo mismo: que frontend no dependiera de parsear mensajes para decidir qué mostrar. Pero la implementación quedó distinta porque cada framework empuja el diseño por lugares diferentes.
1. El problema: errores útiles para backend, frontend y usuario final
El error de backend tiene varias audiencias al mismo tiempo:
- backend necesita semántica HTTP correcta
- frontend necesita una señal estable para decidir flujos y feedback
- quien mantiene el sistema necesita un mensaje entendible para debugging
Si devolvés solo un mensaje, mezclás las tres cosas en el mismo campo.
Si devolvés solo status code, te quedás corto para la UX.
Si devolvés estructuras distintas según el módulo, la integración se degrada enseguida.
Lo que quería evitar en ambos proyectos era este tipo de lógica del lado cliente:
if (response.message.includes('already exists')) {
  showConflictToast();
}
Ese patrón no escala bien, rompe fácil con cambios de redacción y vuelve frágil algo que debería ser mucho más explícito.
2. Qué queríamos resolver en ambos proyectos
Aunque los dominios son distintos, la intención fue prácticamente la misma.
En proyecto-atlas-api necesitaba una base chica pero consistente para una API nueva, con CRUD de proyectos y documentación, donde ya quería cerrar contratos claros desde el arranque.
En modo-playa-api el problema aparecía en un sistema más grande y más cargado de reglas:
- multi-tenant
- auth con JWT
- validaciones de ownership
- media
- errores de dominio más variados
En ambos casos el objetivo era que un consumidor pudiera apoyarse en una estructura estable y no en un texto accidental.
3. La idea central: statusCode + message + code
La estructura que me terminó cerrando en ambos casos fue bastante simple:
{
  "statusCode": 409,
  "message": "Project slug 'proyecto-atlas' already exists.",
  "code": "PROJECT_SLUG_CONFLICT"
}
Lo importante acá no es el shape por sí mismo. Lo importante es la semántica de cada parte:
statusCode: semántica HTTP realmessage: mensaje orientado a desarrollo y diagnósticocode: identificador estable para lógica de frontend y UX
De los tres, el que más me importa proteger en el tiempo es code.
El mensaje puede cambiar de redacción. Puede mejorar. Puede volverse más claro.
El code, en cambio, es el contrato que le permite al frontend saber si está frente a:
- una validación
- un conflicto
- un recurso inexistente
- una restricción de dominio
- un error interno
4. Cómo lo resolví en NestJS en modo-playa-api
En modo-playa-api la base está en DomainException.
Ahí encapsulé dos decisiones:
- los errores conocidos de dominio devuelven
message + code - el status HTTP viaja como parte del
HttpExceptionde Nest
La clase queda así, bastante chica:
export class DomainException extends HttpException {
  constructor(message: string, code: ErrorCode, status = HttpStatus.BAD_REQUEST) {
    super({ message, code }, status);
  }
}
Sobre esa base aparecen especializaciones como AuthException, que fija 401 para errores de autenticación sin duplicar toda la estructura.
Además centralicé los códigos en error-code.ts, con entradas como:
INVALID_CREDENTIALSUSER_DISABLEDCONTACT_NOT_FOUNDINVALID_OWNER_IDLODGING_IMAGE_LIMIT_EXCEEDED
Eso me dio un vocabulario estable entre módulos que el frontend puede consumir sin depender del texto.
Validación consistente también en el pipe global
La otra pieza importante es app-validation.pipe.ts.
No quería que los DTOs validados por class-validator devolvieran una estructura y los errores de dominio devolvieran otra. Por eso la ValidationPipe global termina levantando también una DomainException.
El punto interesante es que, además de normalizar el shape, hace un pequeño mapeo por contexto:
targetOwnerIdinválido ->INVALID_TARGET_OWNER_IDcontactIdinválido ->INVALID_CONTACT_IDuploadSessionIdinválido ->INVALID_UPLOAD_SESSION_ID- casos genéricos ->
REQUEST_VALIDATION_ERROR
No es un motor enorme de errores. Es una capa pragmática para que validación automática y errores de aplicación hablen un lenguaje más parecido.
Errores de dominio distribuidos en servicios concretos
Después, en servicios como contacts.service.ts o auth.service.ts, los casos conocidos tiran excepciones con código explícito:
throw new DomainException(
  'Contact not found',
  ERROR_CODES.CONTACT_NOT_FOUND,
  HttpStatus.NOT_FOUND,
);
o:
throw new AuthException(
  'Invalid credentials',
  ERROR_CODES.INVALID_CREDENTIALS,
);
También usé el mismo criterio en utilidades como toObjectIdOrThrow, para que un ObjectId inválido no termine devolviendo errores inconsistentes según desde dónde se invoque.
5. Cómo lo resolví en ASP.NET Core en proyecto-atlas-api
En proyecto-atlas-api el enfoque tiene la misma intención, pero la implementación cae más naturalmente en middleware y excepciones conocidas.
La base está en KnownException:
public abstract class KnownException(string message, string code, HttpStatusCode statusCode)
    : Exception(message)
{
  public string Code { get; } = code;
  public HttpStatusCode StatusCode { get; } = statusCode;
}
Esa clase me dejó una base común para errores conocidos de aplicación, como:
Los códigos viven centralizados en AtlasErrorCodes.cs.
El middleware centraliza todo el mapeo HTTP
La pieza clave del lado API es ApiExceptionMiddleware.
Ahí la lógica es:
- si la excepción es conocida, responder con su
statusCode,messageycode - si no lo es, loguear y responder
500conINTERNAL_SERVER_ERROR
Simplificado, la idea es esta:
try
{
  await next(context);
}
catch (KnownException ex)
{
  await WriteErrorResponse(context, (int)ex.StatusCode, ex.Message, ex.Code);
}
catch (Exception ex)
{
  log.Error(ex);
  await WriteErrorResponse(context, 500, "An unexpected error occurred.", "INTERNAL_SERVER_ERROR");
}
Esa centralización me gustó bastante por algo simple: los casos de dominio viven en aplicación, pero el shape HTTP final se resuelve en un solo lugar.
Validación automática también alineada al mismo contrato
En Program.cs también ajusté InvalidModelStateResponseFactory para que la validación automática del framework no rompa la uniformidad.
En vez de dejar la respuesta default de ASP.NET Core, la API devuelve:
400The request payload is invalid.VALIDATION_ERROR
Eso me permitió cerrar otra pieza del problema: errores conocidos, errores de validación y errores inesperados terminan todos bajo la misma estructura.
Swagger con ejemplos reales del contrato de error
Otra diferencia concreta frente a modo-playa-api es que en Atlas dejé el shape de error especialmente visible también en OpenAPI.
En OpenApiExampleTransformers.cs el schema de ApiErrorResponse ya expone un ejemplo como:
{
  "statusCode": 409,
  "message": "Project slug 'proyecto-atlas' already exists.",
  "code": "PROJECT_SLUG_CONFLICT"
}
Eso ayuda bastante a que el contrato no quede implícito ni enterrado en README o en pruebas manuales.
6. Qué se parece entre ambos enfoques
Más allá del framework, hay varias decisiones conceptuales que son prácticamente iguales.
Los errores conocidos tienen una base común
En ambos proyectos hay una abstracción base:
KnownExceptionen ASP.NET CoreDomainExceptionen NestJS
La idea es la misma: si el error es esperable desde el dominio o la aplicación, no debería salir como una excepción genérica sin contrato.
El code estable es parte del diseño, no un accesorio
Los dos repos centralizan códigos explícitos:
AtlasErrorCodesERROR_CODES
Eso evita que cada módulo invente su lenguaje y también reduce el riesgo de que frontend termine acoplado al wording de un mensaje.
Validación y errores de negocio terminan convergiendo
En ambos casos busqué que la validación automática del framework no devolviera una estructura paralela. Esa convergencia me parece importante porque, si no, el frontend tiene que manejar dos o tres contratos distintos para errores que igual forman parte de la misma interacción.
Los errores desconocidos también reciben una forma estable
Esto me importa bastante. El contrato uniforme no vale solo para los errores “lindos”. También conviene que un error inesperado termine con un shape controlado en vez de respuestas arbitrarias o stack traces.
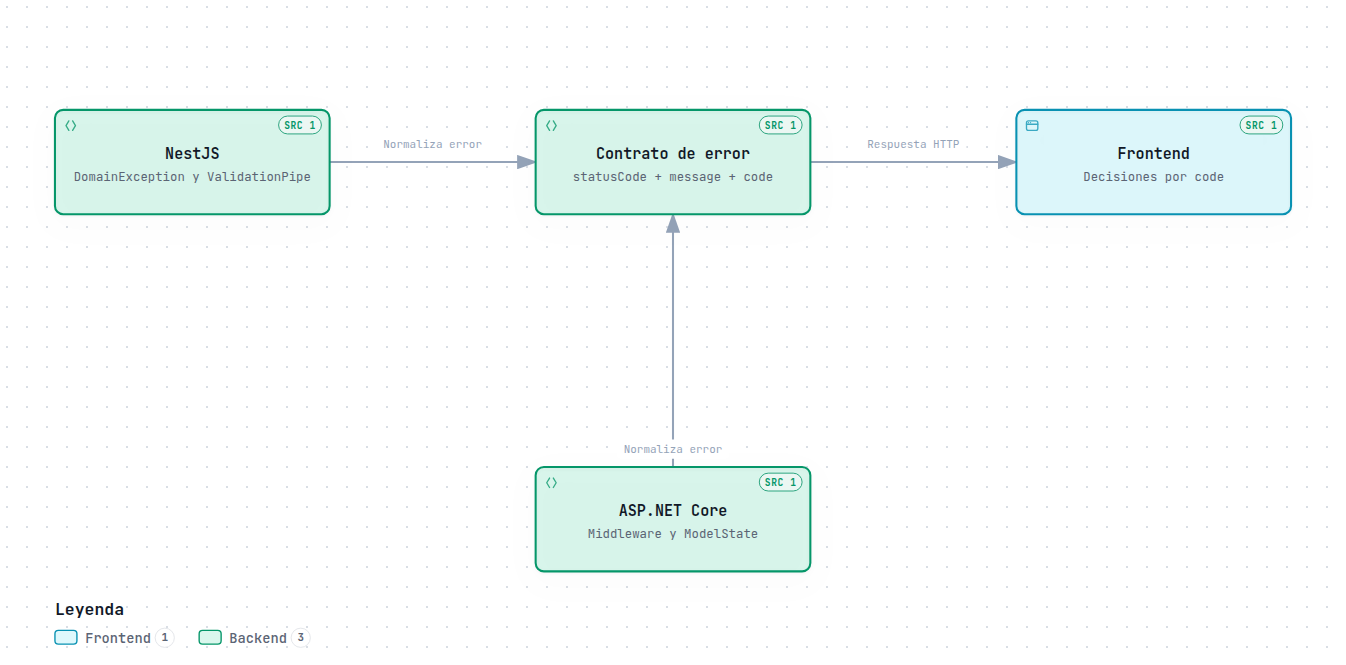
Explorar el contrato de errores entre API y frontend.
7. Qué cambia por culpa o a favor del framework
Acá es donde los dos stacks empiezan a separarse de verdad.
ASP.NET Core empuja más naturalmente a middleware
En Atlas, el punto natural para capturar y mapear excepciones es middleware.
Eso tiene ventajas:
- el mapeo HTTP queda muy centralizado
- la app y el dominio no necesitan saber demasiado del pipeline web
- manejar errores desconocidos y logging cae en un lugar bastante obvio
La contracara es que parte del contrato final se entiende mejor si mirás también la capa API, no solo aplicación.
NestJS empuja más a excepciones HTTP y pipes
En Modo Playa, el diseño encaja más naturalmente en:
HttpException- excepciones custom
ValidationPipe
Nest también tiene exception filters como equivalente conceptual más cercano al middleware de errores, pero en este repo no necesité agregar un filter propio para cerrar el contrato principal. Con DomainException y la pipe global ya alcanzó para resolver el caso actual con bastante consistencia.
Eso también muestra una diferencia práctica: en NestJS muchas veces el framework ya espera que el error conocido viaje cerca del controller/service como una excepción HTTP-aware, mientras que en ASP.NET Core me resultó más natural separar mejor la excepción conocida del mapeo final en middleware.
8. Beneficios concretos para frontend y mantenimiento
La mejora principal no es estética. Es operativa.
Para frontend
- deja de depender de parsear mensajes
- puede mapear
codea feedback de UX - maneja validaciones y conflictos con menos ambigüedad
- reduce coupling con wording del backend
Para backend
- el vocabulario de errores queda más explícito
- es más fácil revisar drift entre módulos
- los errores nuevos obligan a pensar si el caso merece código estable o no
- debugging sigue teniendo un
messageútil sin convertirlo en contrato
Para documentación
En Atlas esto además quedó visible en Swagger con ejemplos concretos.
En Modo Playa, aunque el enfoque es distinto, el README y el contrato operativo ya dejan claro que code es parte explícita de la respuesta y no un detalle accesorio.
9. Trade-offs y límites
No todo es ventaja.
Mantener un contrato de errores estable también tiene costo:
- hay que sostener el catálogo de códigos
- aparecen decisiones grises sobre granularidad
- cambiar un
codedespués puede romper consumidores - si exagerás, terminás con un inventario enorme y difícil de mantener
También hay un límite práctico: no todos los errores merecen una taxonomía súper fina. A veces alcanza con un código más general y un buen message.
El punto no es modelar cada borde con obsesión. El punto es que frontend tenga señales confiables para los casos que realmente afectan flujo y experiencia.
10. Lo que me dejó trabajar esto en múltiples stacks
La parte más interesante de haber resuelto este problema en ASP.NET Core y en NestJS es que la idea de fondo casi no cambió.
Lo que cambia es la bajada:
- en un caso, middleware + excepciones conocidas
- en el otro,
HttpException+ pipe global + convenciones de Nest
Pero el criterio se mantiene bastante estable:
- errores conocidos con contrato explícito
- validación alineada al mismo shape
- error desconocido también controlado
codeestable como interfaz real para frontend
Cuando un equipo trabaja con varios stacks, eso me parece más valioso que copiar literalmente el mismo patrón. No necesito que dos frameworks se vean iguales. Necesito que resuelvan el mismo problema con una intención coherente.
Y en este caso la intención fue bastante concreta: que el error deje de ser un texto suelto y pase a ser parte seria del contrato de la API.